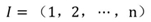
【探索】秦时分析学新方法
秦时分析文吧
全部回复
仅看楼主
level 9
本文以探究新分析方法为主要目的,可能涉及经济学、电影符号学、传播学、密码学、信息论等等,本人均是现学现卖且很可能得不到什么结果,如有内容错误,欢迎批评指正。
如果你看烦了一般的分析,我这里可以给你一个不一样的。
2017年07月23日 12点07分 1
level 9
一.从孔多塞悖论到秦时武力排行
孔多塞悖论又称投票悖论,是一个十分著名的悖论。这个悖论是说,设社会中共有A、B、C三人,此三人对X、Y、Z三种方案的偏好如下——
A:X>Y>Z
B:Y>Z>X
C:Z>X>Y
根据少数服从多数原则,由于A、B皆认为Y比Z要好,因此社会总体也应认为Y好于Z;
同理,由于B、C皆认为Z比X要好,因此社会总体也应认为Z好于X;
由于C、A皆认为X比Y要好,因此社会总体也应认为X好于Y;
于是我们得到一个矛盾的社会偏好排序——
X>Y:Y>Z;Z>X
我们可以轻易地将此运用到秦迷们关于秦时各角色武力排行的争论上:
比如,假设有三名观众A、B、C,其对盖聂、卫庄、无双鬼谁更强(强弱用“>”“<”表示)的看法如下:
A:无双鬼>卫庄>盖聂
B:卫庄>盖聂>无双鬼
C:盖聂>无双鬼>卫庄
综合三名观众意见,我们得到;卫庄强于盖聂,盖聂强无双鬼,且无双鬼强于卫庄
2017年07月23日 12点07分 2
level 9
###################################################################################
用
表示观众集合,由m个字母构成的
表示角色集合,现要求每个观众
对全体角色投票,即对A的一个排序,记作
。所谓武力排行是根据
确定排行结果,即群体对A排序,记作p.
作为对集合A的任意一个排序
和p,须具备以下两个性质:
1.完全性:对于任意的
,下面三种关系必有且仅有一种成立:x>y,x<y,
(x等同于y)
2.传递性:对于
,若x≥y,y≥z,则x≥z
##################################################################################
2017年07月23日 12点07分 4
level 9
阿罗提出以下4条公理:
公理一:个人偏好的无限制性。对可能存在的所有备选方案,逻辑上可能的个人偏好都不应当先验地被排除
公理一:个人偏好的无限制性。对所有角色,逻辑上可能的个人偏好都不应当先验地被排除
#############################################
公理二:非独裁性。不存在这样的社会成员i,使得对于任意一对备选方案x、y,只要
中有(x>y),武力排行就确定x>y
公理二:非独裁性。不存在这样的秦迷i,使得对于任意一对角色x、y,只要
中有(x>y),武力排行就确定x>y
#############################################
公理三:弱帕累托原则,即一致性原则。当所有社会成员都认为某种备选方案优于另一种时,那么社会也应如此认为
公理三:弱帕累托原则,即一致性原则。当所有观众都认为某个角色武力优于另一个时,那么观众总体也应如此认为
#############################################
公理四:无关方案独立性。设
是集合A的子集,若在两次投票
和
中
内各备选方案的排序相同,那么投票规则确立的两次投票结果p和
中
内各备选方案的排序也应相同
2017年07月23日 13点07分 5
level 9
这个公理表明,尽管
以外的备选方案在
和
中的排序可以变化,但这不能影响
内各备选方案在排行结果中的排序
公理四:无关角色独立性。设
是集合A的子集,若在两次排行
和
中
内各角色的排序相同,那么排行规则确立的两次排行结果p和
中
内各角色的排序也应相同
2017年07月23日 13点07分 6
level 9
这个公理表明,尽管
以外的角色在
和
中的排序可以变化,但这不能影响
内各角色在排行结果中的排序
例如,对于盖聂、卫庄、鬼谷子,无双鬼,月神某次排行结果为(盖聂>卫庄>鬼谷子>无双鬼>月神),另一次排行结果为(无双鬼>鬼谷子>盖聂>卫庄>月神),两次结果盖聂均在月神前面,其他角色顺序虽有变化但不影响盖聂与月神的排序
2017年07月23日 13点07分 7
level 9
那么,是否存在满足以上4条公理的投票规则呢?
当m=1或n=1时,无意义
当m=2,n≥2时,少数服从多数规则就满足上述4条阿罗公理
当m≥3,n≥2时,阿罗证明了:
当至少有3个备选方案和2位社会成员时,满足上述4条阿罗公理的投票规则不存在,
符合条件的社会福利函数不存在
那么,是否存在满足以上4条公理的武力排行呢?
当m=1或n=1时,无意义
当m=2,n≥2时,少数服从多数规则就满足上述4条阿罗公理
当m≥3,n≥2时,阿罗证明了:
当至少有3个角色和2名观众时,满足上述4条阿罗公理的武力排行不存在
2017年07月23日 13点07分 8
level 9
另一个有趣的排行方式是使用记分规则进行排行。
我们设
为排序
中劣于x的角色数目,定义
为x在排行中所得的分数,称之为武力值,记分规则规定,当且仅当B(x)>B(y)时,x>y成立。
如,在一次两人排行中,某观众的排行结果(盖聂>卫庄>鬼谷子>无双鬼>月神)中,盖聂后面有4个角色,则盖聂得分为4;另一观众排行结果为(无双鬼>鬼谷子>盖聂>卫庄>月神),盖聂的2分。盖聂总武力值为6。
这种规则下会产生一些不合理的情况,比如,观众I=(1,2,3,4),角色A=(卫庄、盖聂、鬼谷子,无双鬼,月神),排序情况为
,
,
:卫庄>无双鬼>盖聂>鬼谷子>月神
:无双鬼>盖聂>鬼谷子>月神>卫庄
则可算出卫庄武力值B(卫庄)=12,无双鬼武力值B(无双鬼)=13,武力排行结果为无双鬼>卫庄,然而我们知道,实际上4位观众中有3为都认为卫庄>无双鬼。
2017年07月23日 13点07分 9
level 9
我们还可以将此应用到观众对各故事线喜好的排行上或是观众对各种剧情走向喜好的排行上。以上内容说明,如果方法不当,玄机所获取的观众公共意见可能实际上是由某一位“独裁的”秦迷的意见决定的。
2017年07月23日 13点07分 10
level 9
二.视听作品信息量量化理论的初步构建
在评价一部作品时,观众有时会使用“信息量大”这种描述,多见于剧情复杂晦涩难懂、语速快、节奏快或台词多的作品。那么,这个所谓的“信息量”,究竟如何相互比较呢?究竟如何去量化呢?
上个世纪60年代,随着法国结构主义思想运动的兴起,以法国人麦茨1964年发表《电影:语言系统还是语言》为标志,电影符号学诞生了。让我们来介绍几个电影符号学的概念。
符号:携带意义的标记。包括视觉符号(人物影像、实物影像、纯虚拟影像)、听觉符号(音乐、声响、人声)、语言符号(话语、文字)
片面化:符号载体必须能被感知,但被感知的不是物本身,而是物的某些品质。物不需要全面被感知才能携带意义。符号的目的是携带意义,这就迫使接受者对物的感受“片面化”。
如,在画面中白凤如芭蕾舞者一般踮起脚尖站在地面上,若有所思地看着用两根手指夹住的一片羽毛。一些观众只接受到了“帅”,另一些观众只接受到了“**”,还有一些观众什么也没接收到,认为这一段纯粹是浪费时间。
文本:由符号组成的合一的表意单元,是文化上有意义的符号组合。可以是唱片、绘画、乐谱、电影、化学公式等人工符号构成的文本。符号文本是接受者进行“文本化”的结果,文本化就是对事物片面化感知的方式:接受者不仅挑拣符号的各种可感知方面,而且挑拣感知的成分进行组合。
伴随文本:任何符号文本,都携带了大量社会约定和文化联系,这些约定和联系不一定显现在文本之中,而是隐藏在文本之后,文本之外,或文本边缘。它们只是被文本顺带着牵连出来,却积极参与文本意义的构成。在解释中,伴随文本甚至可能比文本有更多的意义。因此,所有的符号文本,都是文本与伴随文本的结合体。这种结合,使文本成为一个浸透了社会文化因素的复杂构造。包括生产性伴随文本和解释性伴随文本
生产性伴随文本:副文本(片头片尾职员表、字幕)、型文本(指明文本从属集群)、前文本(一个文化中先前的所有文本,全部文化语境构成的网络,对此文本生成产生的影响。狭义的前文本比较明显:文本中的各种引文、典故、戏仿、剽窃等都指向这种影响。如秦时明月片中出现的刘邦,是历史中真实存在的人物,自带一个关于历史上的刘邦的一切的全文本)
解释性伴随文本:文本生成之后到被接收之前,所出现的评价,包括有关此作品及其作者的新闻、评论、八卦、传闻、指责、道德或政治标签等。再如分析党写的分析文。它包括评论文本(电影相关新闻、片花、主创访谈等)、链文本、先-后文本(存在特殊承接关系的一组文本,如续作、翻拍、前传等)。
全文本:在当今的多媒介时代,某些伴随文本甚至已经融入文本,解释时不可能把两者分开。全文本就是文本加上在解释它时不可能摆脱的那些伴随文本而形成的总体。
符码:符号的意义并非现成,意义有待于解释。控制文本形成时的意义植入规则,控制解释时的意义重建规则,都称为符码。符号信息的发出者,依照符码,对符号进行“编码”,意义就被编织入符号文本,文本就带上了意义。符号信息的接收者,对符号进行“解码”,信息就变换成意义。
文本-艺术符号文本,属于弱编码。接受者对符号信息的解释,一方面享有很大机动余地,另一方面也苦于没有证据说明他的解释肯定正确。对文本的理解,就是开始一次新的表意:解释只是对文化文本,提出一种自圆其说,自己满意的解释。
一个构想是,把所有符号都转化成文字符号,组成一个文字文本,我将其称之为全文字文本。这个全文字文本的涵盖面比剧本更广,包含剧中的一切。在其构造过程中,非文字文本要在奥卡姆剃刀原则下转化为文字文本。怎么转化,暂且不表,我们先来看看如果能够成功,能给我们带来什么。
我们定义如下名词:
信息密度:单位时间内传递的信息量,用ρ表示,单位是bps
让我们以单纯的台词做例子,台词密度即为单位时间内传递的台词量。台词的单位是字,单位时间可以是秒或分。
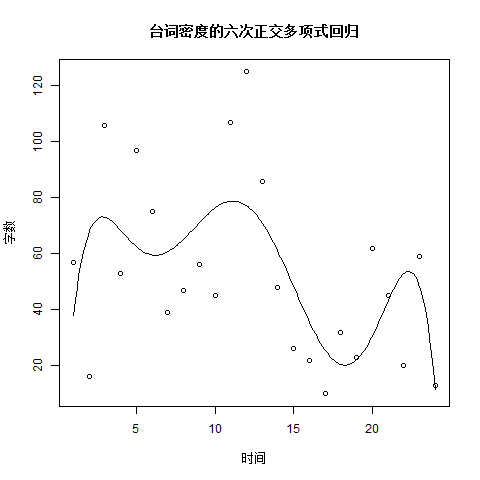
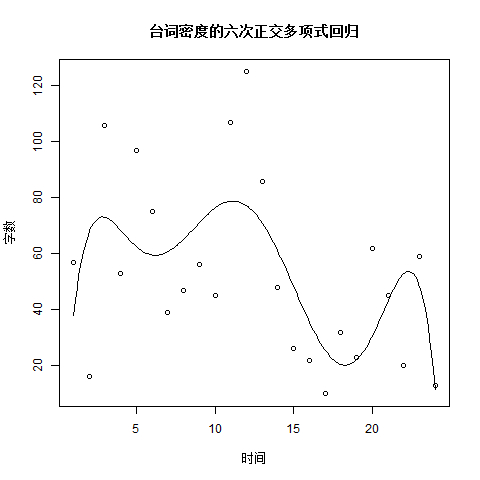
秦时明月45集是第五部我最喜欢的一集。这集从3:26开始,至17:46结束,共计860秒,台词共1643个字。假设一个汉字是16比特。则总台词密度ρ=1643×16÷860≈30.5674(bps),或者说1.91字/秒。
我们还可以每半分钟做一个字数统计,得到台词分布
这同时也是以字/半分钟为单位的台词密度表。
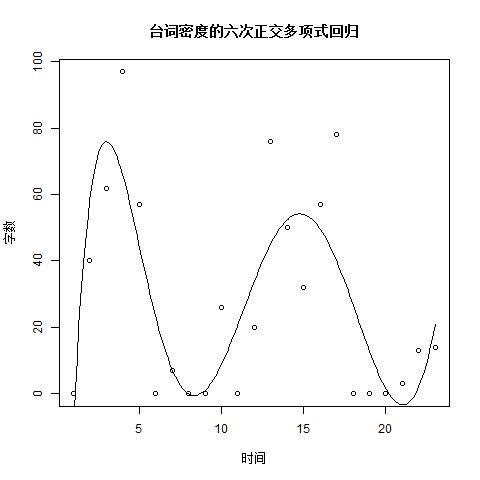
做一个非线性回归,我们拟合出一个一集下来台词分布函数(注:这个分布函数,和概率论中的分布函数的含义并不一样,实际上台词分布得到的是个时间序列)
2017年07月23日 13点07分 11
level 9
信息分布的分析与台词分布的分析是类似的。我们关心的问题是:什么样的信息分布对观众来说是最舒适的?
在此我大胆设想:服从双峰分布(形状类似于45集的台词分布)的信息分布是最佳的。(再声明一下,这个“服从……分布”只是借用概率论的说法,和概率论中的含义并不一样)
对比:
《幻镜诺德琳》第一集,长度1865秒,字数3057字,总台词密度ρ=3057÷1865≈1.6391(字/秒)(开头有一段打斗)
《少年锦衣卫》第一集,共720秒,字数1269字,总台词密度ρ=1269÷720≈1.7625(字/秒)
《天行九歌》第30集,共673秒,字数632字,总台词密度ρ=632÷673≈0.9391(字/秒)
2017年07月23日 13点07分 12
level 9
这是今年4月底写的,因为最近又写了第三部分,所以把这部分内容搬运至此。明天将更新第三部分:《农家线共登场分析——一张社交网络图的生成》
2017年07月23日 13点07分 13
level 9
三.农家线共登场分析——一张社交网络图的生成
(一)亲密度矩阵的构造
1.共现分析(Co-occurrenceAnalysis)介绍
2.影视作品中的“共现”
由此我们可以想到,我们可以把这种分析方法引入到故事中人物关系的分析上来。我们只要把1中的“文档”替换为“场景”,“关键词”替换成“角色”,共现分析就成了“共登场分析”——如果两个角色在同一个场景中出现,意味着两者发生了联系。我们可以把包容度重新定义为亲密度,包容矩阵成为亲密度矩阵。
3.场景划分与角色登场表的建立
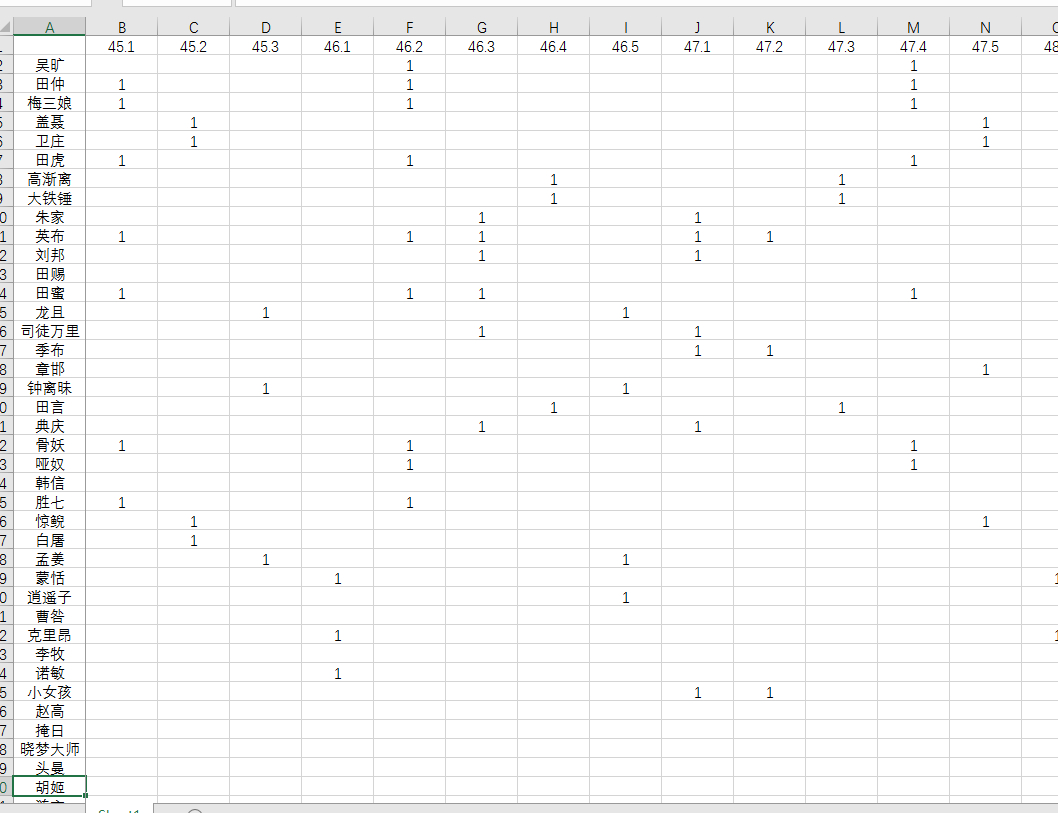
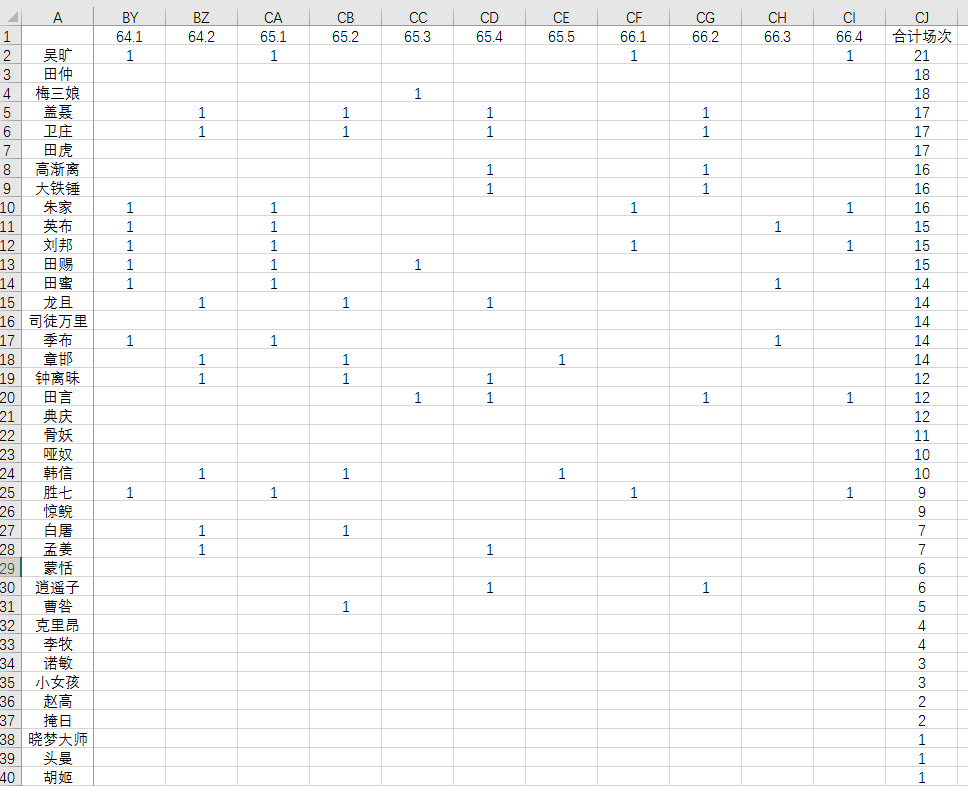
角色登场表,我们可以这样设置:纵轴是角色,横轴为场景,如果一个角色在一个场景中出现,我们就在对应的位置写上1.如果我们有秦时的剧本的话,建立登场表就简单许多了,剧本一般会分出场景,每个场景有谁登场都十分清楚。然而我们没有。
因此,我们只能自己来分。我观看了秦时明月之君临天下第45集到第66集的内容,做成了下表。
角色共计43个,场景共有86个。
由于本人没有学过编剧或导演,因此场景的划分我都是按照自己对秦时明月中空间的理解来进行的。并且为了方便,不同集数的相同场景,我都按不同场景来算;同一集中的相同场景,在没有相连的情况下(秦时的剪辑你们是知道的),如果没有新人物登场,算同一场景,有新人物登场,算不同场景。这就是我划分场景的基本原则。
在有了这张表之后,我们就可以生成亲密度矩阵了。我们把这张表导入R来做这件事。代码如下:
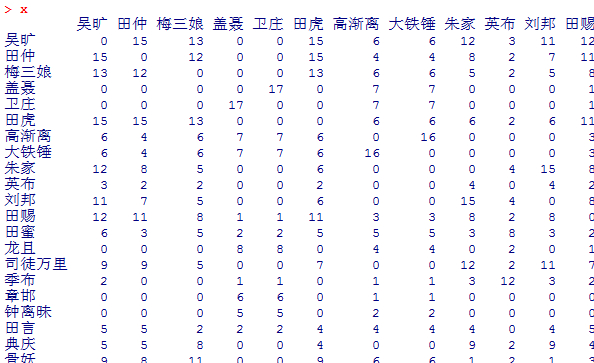
写代码本人并不擅长,如果写复杂了,望诸位莫取笑。解释一下这段代码:我们任意找到两行,将两行对应的元素相加,新的向量中2的个数就是对应的两个角色的共登场的次数。我们再找出两个角色的总登场次数中小的那一个,二者相除,就是两角色的亲密度。确实如大家所说,R运行for比较慢,这段代码R运行了将近30秒才完成。
于是,我们得到亲密度矩阵如下图。
让我们把它做得更漂亮些。(1.07M,建议下载查看)
至此,我们本应该利用CiteSpace软件生成亲密度图谱,奈何本人从未用过该软件,玩不转,只好就此作罢。
二.农家线秦时角色社交网络
但本文不会就此结束。
实际上,只要我们将之前的代码稍作修改,就可以得到邻接矩阵。
这里我们生成的是带权邻接矩阵。
什么是邻接矩阵?
我们把一个角色看成一个节点,如果两角色发生过联系,即共同登场过,则用一条线连接两点,这样便能生成一张图。
上图左边是一个无向图,右边是它的邻接矩阵,若左图两点之间有连线则右图矩阵对应的位置上就写上1。这样,一个邻接矩阵就可以描述一张图。如果连接两点的边是有权重的,就用带权邻接矩阵来描述,权重是多少就在对应的位置写多少。
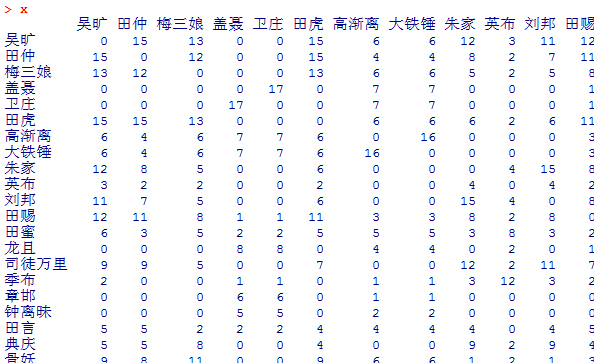
我们生成的矩阵x就是一个无向图的带权邻接矩阵。
下面,我们借助R语言中的igraph包来生成秦时农家线角色的社交关系图,代码如下。
2017年07月24日 13点07分 14
level 9
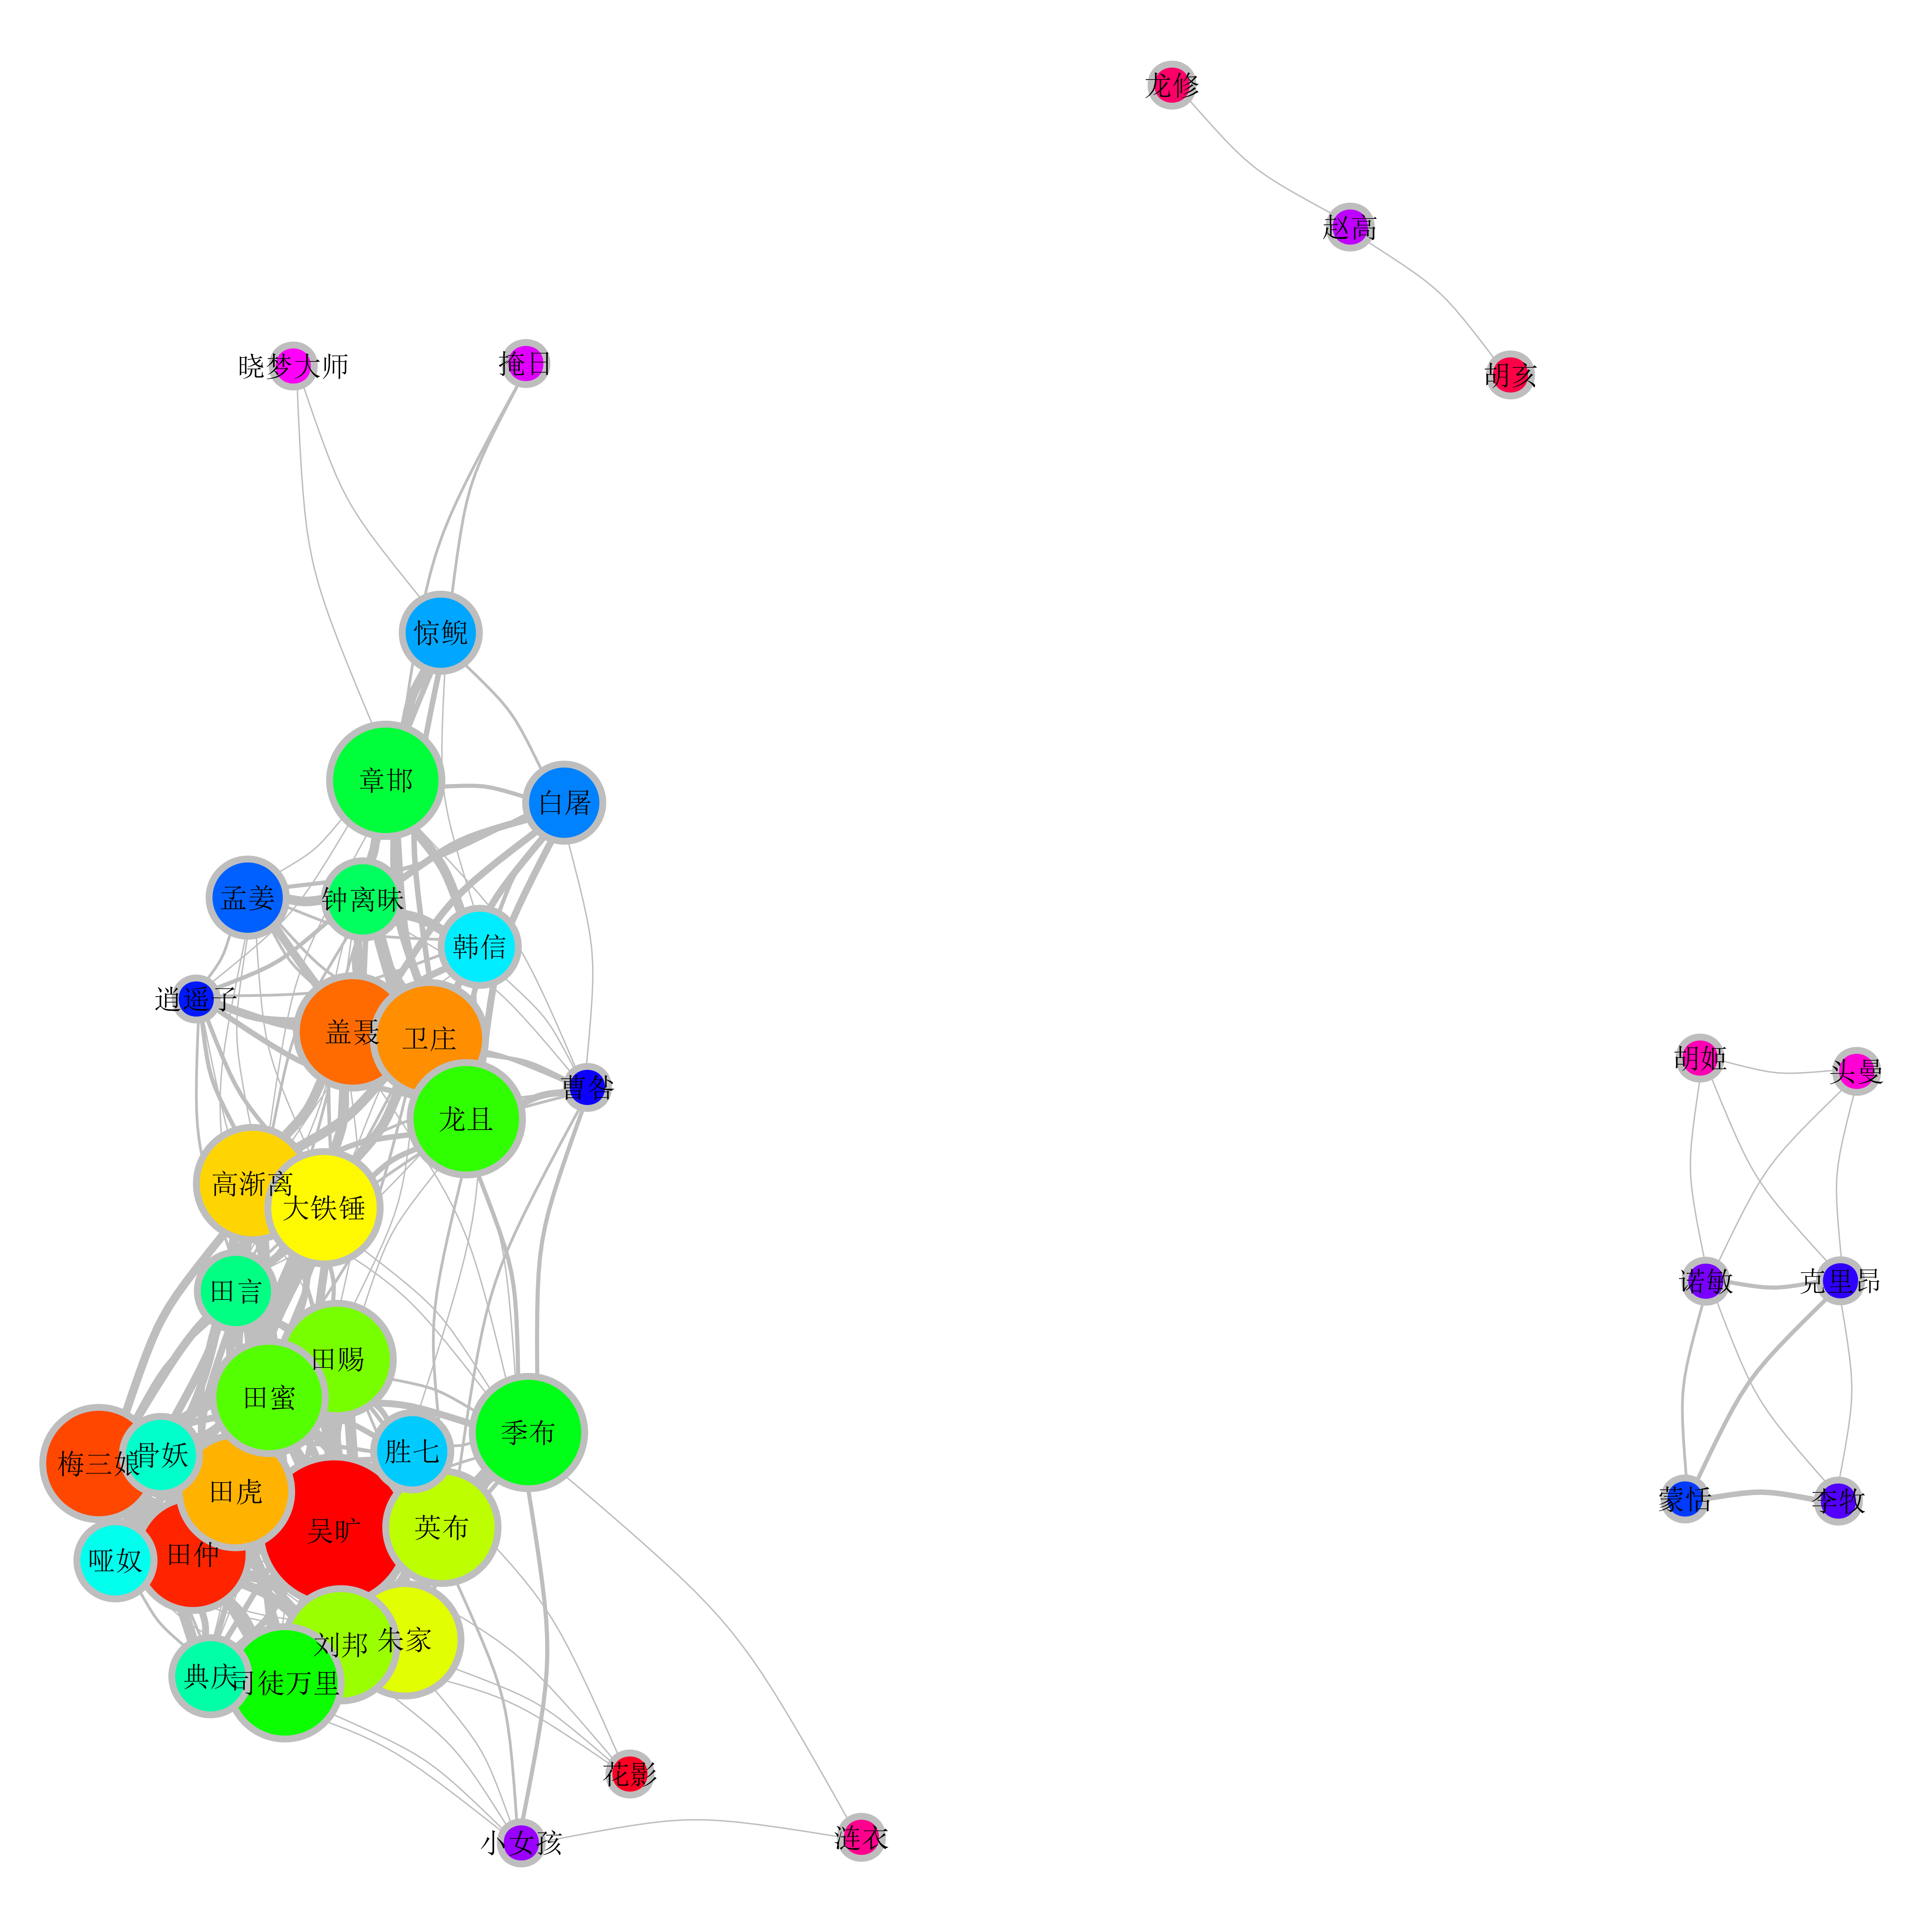
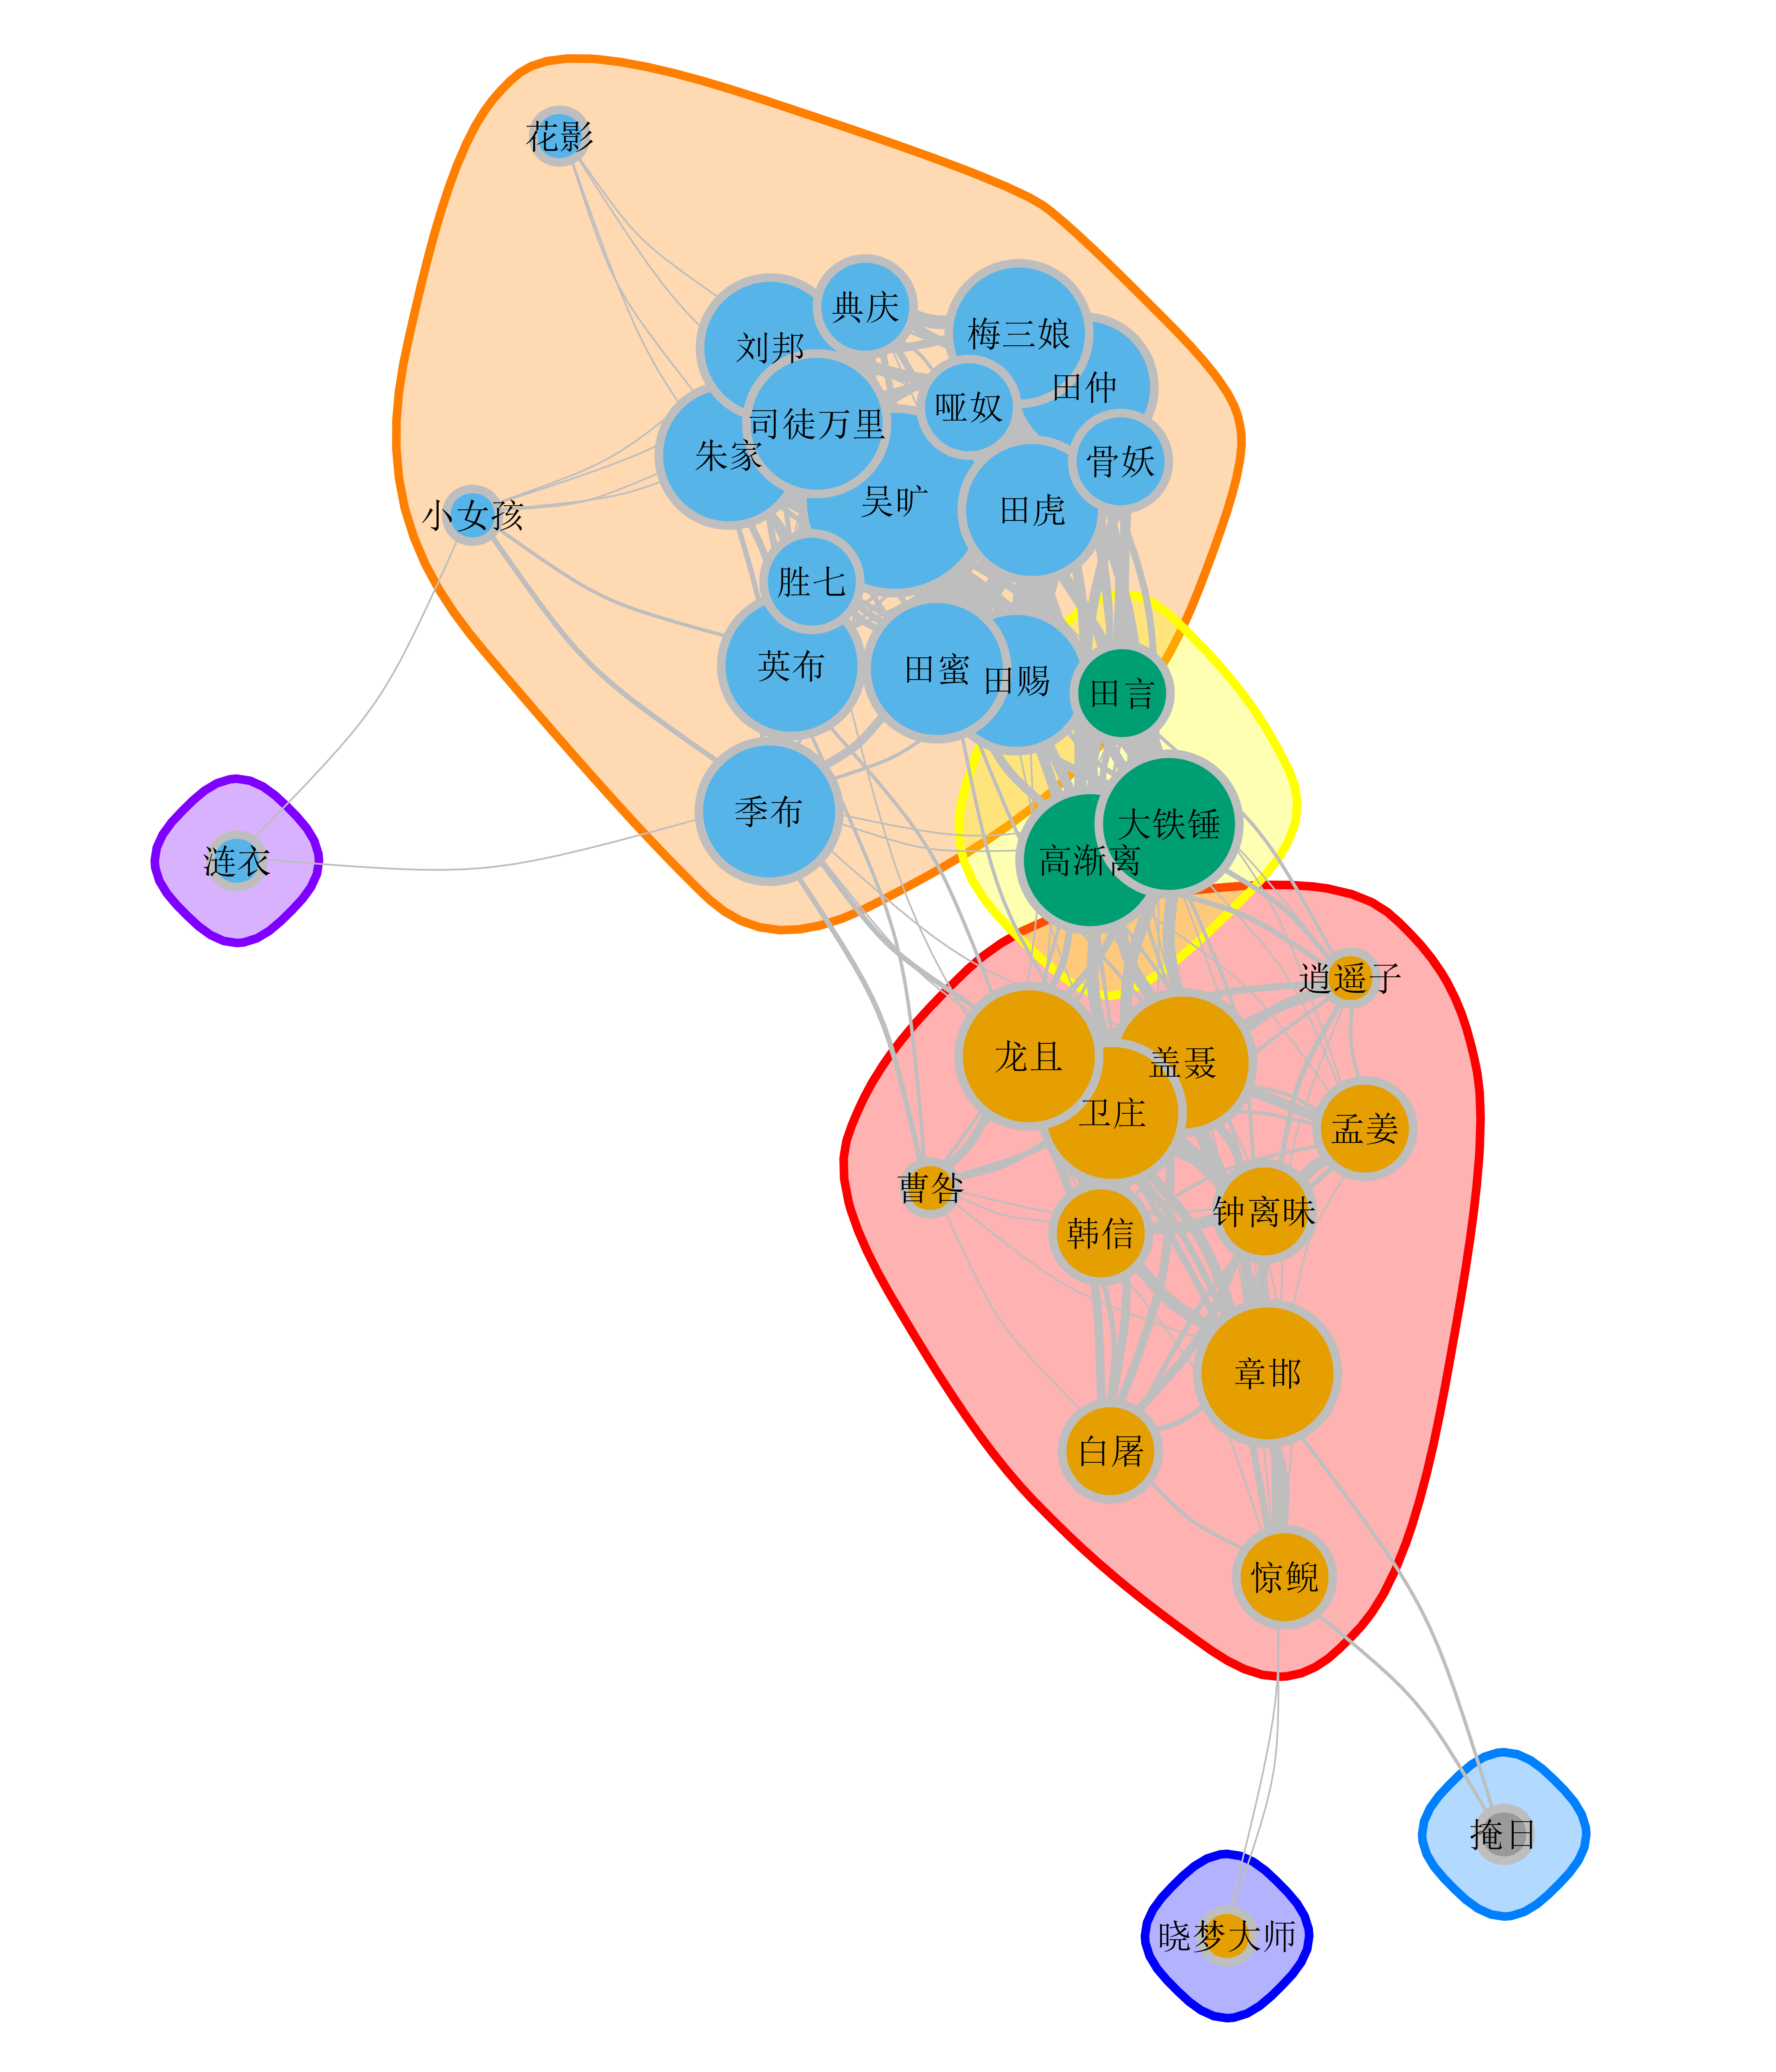
生成的图如下。(1.23M,建议下载查看)
该图中,每一个角色用一个圆代替,圆越大登场次数越多。线的宽度反映权重,线越宽,两角色间权重越大,即共登场次数越多。
我们还可以来个聚类分析,或者说社区发现,方法我选随机游走,结果如下。(1.23M,建议下载查看)
蒙恬那一部分和赵高那一部分我就直接省略了,我们可以明显看到分出了两个大类,而田言、大铁锤、高渐离这一小类起到了连接和纽带的作用。这个图和之前的社交网络图都非常直观,我就不多说了。
如果你看到的比较关键的三张大图(亲密度矩阵、社交网络图、聚类图)不清晰,可以在这里下载:[无效] https://pan.baidu.com/s/1b64Dhc
2017年07月24日 13点07分 15
这样就很直观了 楼主666[真棒]
2017年07月26日 10点07分
level 7
哇塞,将角色各种因素代入理论得出角色权重及相互关系[黑线],虽然是新思路,但是只觉得凭着感性可以得出结论,这样研究的目的和意义就[阴险]
2017年07月25日 04点07分 16
1 2 尾页