距离AMD宣称2x带宽提升还差一点点
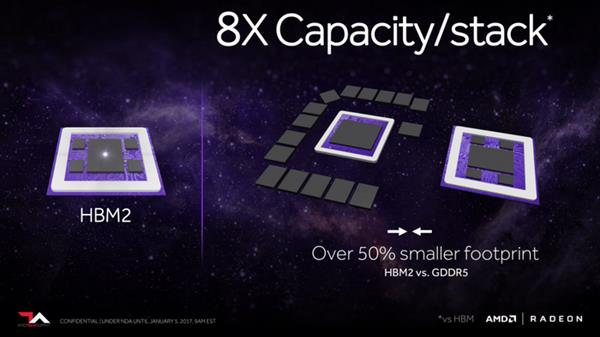
HBM 2显存占用的面积比GDDR5更低,单位面积容量提升8倍
AMD为了展示HBM 2显存性能,演示了一间起居室的照片级渲染画面。原本需要花费数小时去渲染的600GB场景,但在Vega架构配合HBM 2加持下,仅仅几分钟就渲染完成。最终效果还能实时移动镜头去查看房间的角落,细致的画面令人感到震惊。
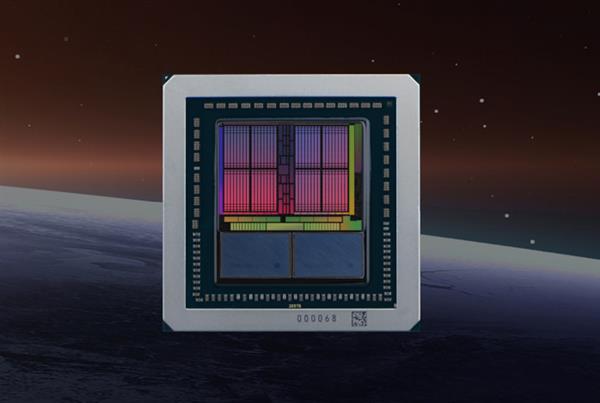
之前AMD放出的Radeon Pro Vega核心渲染图,下面两颗就是HBM 2显存
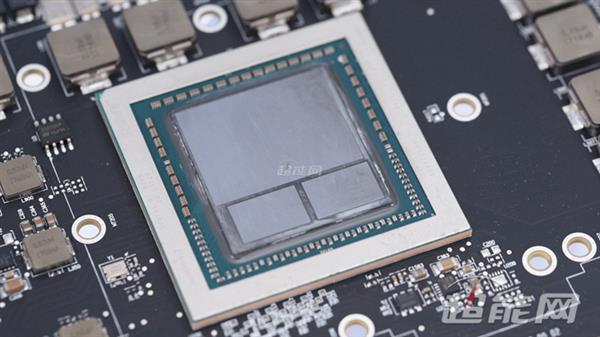
我们拆解的AMD Radeon Vega Frontier Edition显卡核显,与渲染图一致

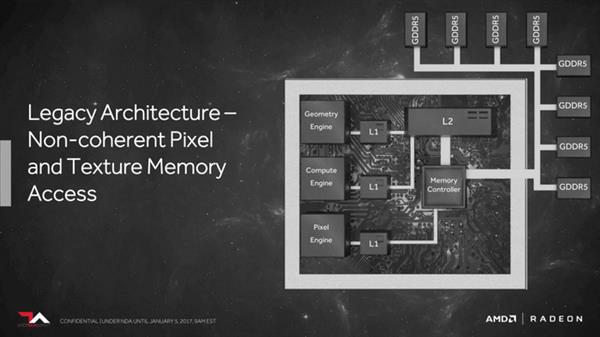
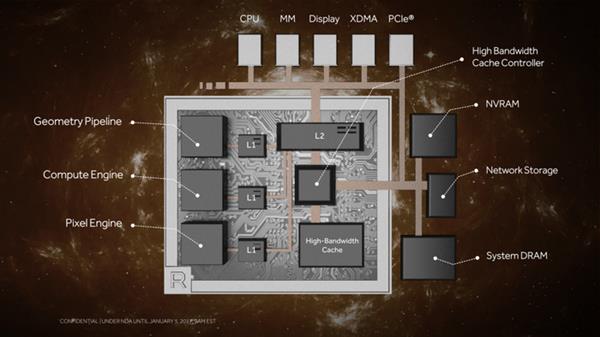
如果说HBM 2显存是Vega显卡一大特色,那么HBCC高带宽高缓存控制器可以说是其杀手锏。从之前显卡架构示意图来看,以往显卡内存控制器只能控制GDDR5显存,Vega大改以后HBCC就厉害了,它还可以连接显卡PCB接入的SSD(Radeon Pro SSG那种)、网络存储、系统DRAM等不同形式的片外存储器件。

HBCC高带宽高缓存控制器
而且AMD表示HBCC的寻址能力高达512TB!也就说未来开发者可以把所有的存储器件都当做显存来用,只要速度够快!如此一来Vega显卡就可以成为一个名副其实的计算卡,看来AMD是为Vega在人工智能、深度计算上隐藏了一个大招。

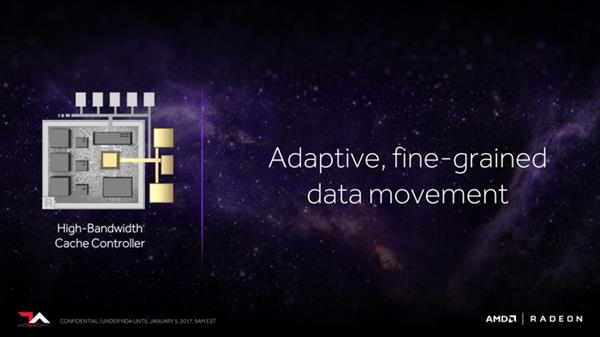
自适应、细粒度数据迁移
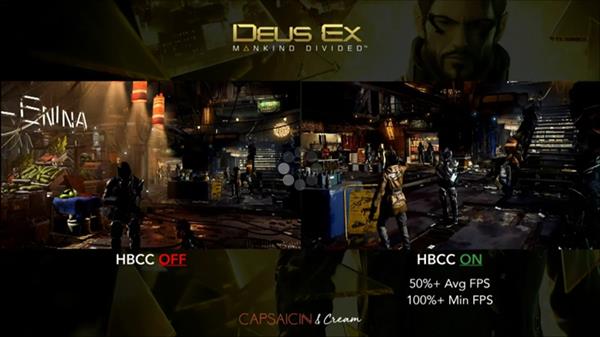
在《杀出重围:人类分裂》中,启用了HBCC(高带宽缓存控制器)后,GPU的显存寻址效率提升明显,对应所需的显存大小需求更小,从而提升了游戏画面速度。在帧率优化演示中,启用了HBCC后,游戏平均帧数提升了50%,最小帧率提升一倍,游戏画面非常流畅。
演示过程中,AMD还将HBCC的显存寻址上限从4GB缩小到2GB,即便如此,在显卡只能使用一半的显存依旧能获得流畅而稳定的游戏画面,这个就要归功于超高带宽的HBM 2显存和高效率的HBCC。
新一代NCU单元:
AMD GCN架构改了一代又一代,不过测试下来一看,每一代的性能提升并不大。今年在Vega上,AMD也是痛定思痛,设计了“全新”的NCU(Next-Generation Compute Engine)架构,不仅优化了IPC性能,还提高了运算单元的灵活性。
一般来说我们玩游戏、3D渲染对于单精度FP32、双精度FP64要求比较高,而在大规模深度计算中却对半精度FP16有非常高的需求,在深度计算领域先行一步的NVIDIA早就意识到这个问题,率先加入了对FP16半精度支持,半精度性能几乎是双精度的两倍,在深度计算上性能优势十分明显。而AMD在Fiji还是Polaris架构上都慢半拍,没有周全考虑到,导致其专业卡在市场是不受青睐。

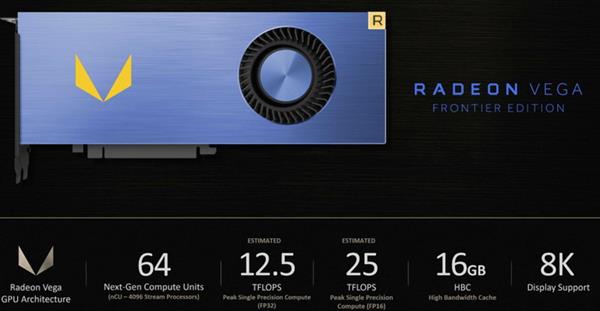
因此Vega GPU中首度引入了紧缩的半精度计算支持,Vega的微架构被称为“NCU(下一代计算单元)”,每个NCU中拥有64个ALU,它可以灵活地执行紧缩数学操作指令,如每个周期可以进行512个8位数学计算,或者256个16位计算,或者128个32位计算。这不仅充分利用了硬件资源,也大幅度提升Vega在深度学习计算的性能。效果也非常显著,在之前公布的Radeon Instinct MI25计算卡就是基于Vega架构的,其FP32单精度浮点性能12.5TFLOPS,而半精度FP16性能直接翻倍到25TFLOPS。


 直到这时候才有些趣闻,比如猪王系列