努力打造技术大楼
tegra吧
全部回复
仅看楼主
level 12
845647723 楼主
1
2013年02月03日 03点02分 1
level 12
845647723 楼主
爱搞机的GPU总结

2013年02月03日 03点02分 2
level 12
845647723 楼主
前言:
现在移动设备的“核战”越来越激烈,已经从CPU引发到了GPU上,于是“16核”,“8管线”,“MP4”“三角形生成率”“填充率”各种吸引眼球的宣传铺天盖地而来。一直很希望能有些文章来介绍科普下,但或许是专业人士都觉得这些太基础,最后忍不住,只能由我这个半桶水的非专业人士来写点啥了。本文参考和引用了网上的一些资料,篇幅有限恕不一一列举。内容尽可能的科普浅显,但限于个人的知识层次、理解能力和表达能力,如果有不确切或者错误的地方,还请多多指正。
基本的3D
流水线
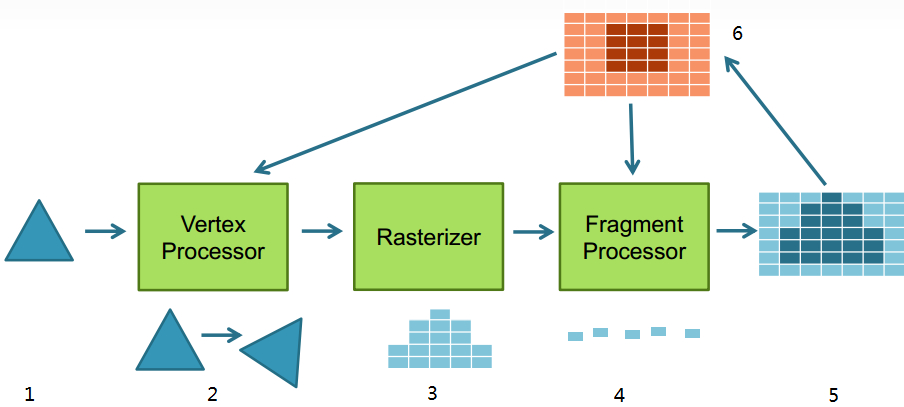
首先我们来简单的介绍下3D的画面是如何生成的,一个基本的3D流水线如下图所示:
首先,运行在CPU上游戏引擎根据游戏中的一些参数,产生一系列的图元,将它们的顶点数据发送给GPU
第二步,顶点处理器(Vertex
Processor)对顶点数据进行一系列的变换和光照处理。简单的想想,游戏中的各个物体的坐标都是参照游戏中的世界坐标系的,而实际显示的画面是玩家视角或者摄像机视角,这中间就有许多坐标系的转换。这些活就需要顶点处理器来做,最终我们得到了我们所需要视角的画面。
但是,到这一步,画面还只是一些多边形,而实际显示在屏幕上的是一个个像素,这里就需要Rasterizer进行光栅化(Rasterization,3),从而将画面变成一个像素图。
第四步,对这些像素进行上色,Fragment
Processor中的像素着色器(Pixel Shader)按照程序规定的算法,计算出画面中每个像素的颜色,之后第五步就是把结果输出到内存中,全部完成后拿去显示。当然在这整个过程中,还跟纹理贴图6有关系。所谓贴图就是把纹理(一个二维的静态图片)按照一定的算法给贴到游戏里的三角形表面上去。
2013年02月03日 03点02分 3
level 12
845647723 楼主

参数,究竟靠谱吗?
终端厂商在宣传他们手机芯片的GPU如何强劲时,往往会提到一些参数,最常见的就是三角形生成率和填充率。但实际上,不同公司的GPU,他们的这些理论参数,并不具有直接的可比性。我们也可以发现,有些GPU可能给出的理论参数很高,但实际表现却很一般,甚至不如一些参数低的GPU。这是因为,各个GPU的供应商,比如IMGtec(PowerVR SGX),高通(Adreno),Vivante(GC系列),ARM(Mali),nVIDIA(GeForce),他们给出这些理论数据的测试方式,可能不太一样。
比如三角形生成率,本身就受到很多测试因素的影响。例如,有些三角形在一开始就会被剔除掉(比如在屏幕外,或者太小了根本覆盖不到一个像素),不会被显示也不会需要执行太多的运算,那么这部分三角形到底应该算吗?如果算进去的话,三角形生成率自然就高了。或者,测试程序把一些已经计算好的坐标提交给GPU,那么GPU的Vertex Shader就不需要进行复杂的计算,数值自然就高了。再或者,并非生成一个三角形就一定需要处理三个顶点。如果有三角形共享顶点,用indexed的办法绘制,顶点的数目就可以减少。就像下图,2个三角形只需要处理4个顶点。如果测试的时候大量使用这种方式,也可以提高三角形生成率的数值。
2013年02月03日 03点02分 4
level 12
845647723 楼主
同样,填充率反映了GPU的像素输出能力。但是厂家给出的理论值,很多都是没有贴图,没有Shader计算,仅仅是生成无色点的能力,跟实际使用的情况有较大的差距。又比如Imagination Technologies 的PowerVR SGX系列给出的填充率,并不是实际值,而是实际值乘以了一个2.5x的系数。这是由于PVR GPU架构的特殊性,可以剔除画面中被遮蔽的部分,不作渲染,减少了无用功。200MHz的SGX540,原生的填充率是400M,而由于这种技术的存在,IMG认为其等效填充率相当于1000M。在实际的场景中,如果遮蔽的部分较多,这个系数可能远超过2.5x。当然,如果场景中遮蔽较少,这个系数相应的也会变小。
事实上三角形生成率和像素填充率作为衡量GPU性能的参数,在PC平台上,几年前就已经被淘汰了。由于从DX8开始,现代GPU都已经由可编程的Shader来代替固定功能的单元实现各种特效,所以Shader的计算能力成为很重要的一点,在移动平台也是一样的。
2013年02月03日 03点02分 5
level 12
845647723 楼主
因此,移动平台的GPU相对于PC平台,也会有一些不同。我们回过头来看一下移动平台的GPU的一些架构。
首先是传统的IMR(Immediate Mode Rendering)架构
目前几乎左右的桌面GPU(nVIDIA,AMD)都是IMR架构,在移动领域,nVIDIA的GeForce ULP和Vivante的GC系列GPU都是属于IMR架构。IMR架构的GPU渲染完物体后,都会把结果写到系统内存中的帧缓存里,因此就可能出现GPU花了大量的时间渲染了一个被遮挡的看不见的物体,而最后这些结果在渲染完遮挡物后被覆盖,做了无用功。这个问题称之为Overdraw。虽然现代的IMR架构GPU在一定程度上可以避免这个问题,但要求应用程序将场景里的三角形按照严格的从前往后的顺序提交给GPU,要完全避免Overdraw还是很困难的。
另一方面,由于IMR架构的GPU频繁的读写和修改帧缓存,因此对带宽的要求比较高,同时也增加了电力的消耗。
所以,大部分的移动GPU都采用TBR(Tile Based Rendering)的架构
2013年02月03日 03点02分 7
level 9
小白路过。
2013年02月03日 03点02分 9
level 12
845647723 楼主
在移动平台的OpenGL ES里,可以指定高、中、低三种不同的精度。对不同的GPU来说,高、中、低精度的实际值略有差别。如下图所示:
对于Adreno和GC系列,无论何种选择何种精度,都会按照FP32精度进行计算。而Mali-400和Tegra的ULP GeForce的Pixel Shader部分不支持高精度,最高只支持中等的FP16精度。绝大部分游戏的Pixel Shader计算都采用中等(FP16)的精度,而Vertex Shader的计算一般是FP32的精度。
其次,关于统一渲染架构(Unified Shader)和分离的渲染架构(Discrete
Shader)。前者的Shader既能进行Vertex的计算,也能进行Pixel的计算,例如PowerVR,Adreno,GC系列。后者的Vertex Shader和Pixel Shader是分开的,典型的比如Mali-400和ULP GeForce。相对来说,统一渲染架构的Shader利用率会高些,在遇到三角形特别多像素特别少,或者相反的情况下,Shader的计算能力不容易被浪费。
2013年02月03日 03点02分 10
level 12
845647723 楼主

GPU
“兼容性”
现在还有个经常被提到的是GPU的“兼容性”问题,这里就要涉及到各个GPU支持的纹理格式了。
首先是ETC1,这个是OPENGL ES 2.0支持的纹理格式,大家都得支持。但这个纹理的一个缺点是不支持alpha通道,所以对于有alpha通道的纹理,就要拆成2个纹理去读取,效率低,浪费了带宽。
而PVRTC是PowerVR自家的纹理格式,同样ATITC是高通Adreno的纹理格式,此外S3TC就是桌面很常见的DXT,微软DirectX 3D的纹理格式,这些都是支持alpha通道的。
PowerVR GPU支持自家的PVRTC和通用的ETC1(iOS下的PVR GPU只支持PVRTC),Adreno支持自家的ATITC和通用的ETC1,NV的GeForce和Vivante的GC系列支持DXT和ETC1,剩下Mali-400只支持ETC1。所以,对应不同的GPU,会有不同的游戏数据包。通用数据包,一般都会采用ETC1,虽然通用,但由于不支持alpha通道要贴图2次,对于非Mali的GPU其实都算是吃亏了。如果用自己支持的其他格式,就不用受这个苦了。对于贴图单元(TMU,Texture Mapping Unit)数目相对较少的Adreno 2xx系列,恐怕更是吃亏。
当然,纹理的支持度只是兼容性的一方面,并不是兼容性问题的全部。
2013年02月03日 03点02分 11
level 12
845647723 楼主
2013年02月03日 03点02分 13
level 12
845647723 楼主

各家的“
多核”
GPU硬件的部分基本说完了,这里总结一个表格,同时给出了GPU厂商官方定义的一个“核”的内容,谁的核里料多,谁比较不厚道,应该也是一目了然了吧。面对各种“16核”“8管线”的宣传,大家也应该能比较清楚的辨别了吧。
2013年02月03日 03点02分 14
level 12
845647723 楼主

跑分跟实际表现不一样?优化很重要!
最后,规格只是GPU的一个方面,实际表现跟架构也有很大的关系。更进一步的,就算是Benchmark中跑分差不多的GPU,在不同的游戏中,实际表现也会有差别。
首先,Benchmark程序,大部分都是公平的,所以本质上,Benchmark都是“零优化”程序,公平起见,他们的纹理会用RGBA的PNG,TGA,或者ETC1纹理,不会用到各个GPU自家的格式。
但是游戏不一样,游戏可以做相应的优化。例如PVR的GPU,可以用4bpp甚至2bpp的PVRTC纹理,相比于未压缩的贴图就可以节省8倍甚至16倍的带宽。而没有被优化到的情况下,可能只能跟着Mali用不支持alpha通道的ETC1,做2次贴图,浪费带宽。部分厂商甚至在通用数据包里放了一些未压缩贴图,那差距就更大了。同款游戏,跑分接近的GPU,iOS上的特效更好,流畅度更佳,就有优化的原因。
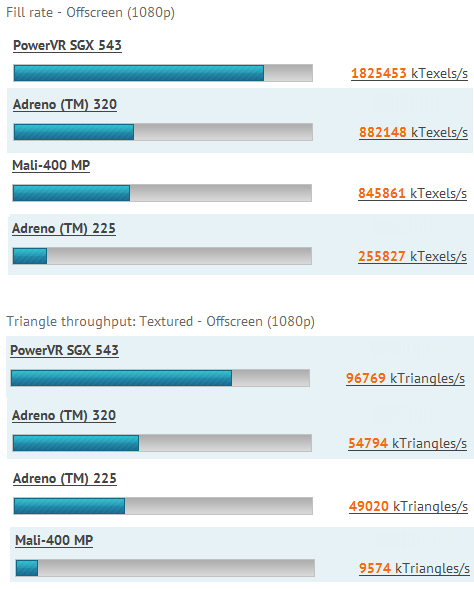
其次,Benchmark在一定程度上都是相对超前的。大部分GPU跑Benchmark的帧率,都不会到流畅的级别(要是满帧了还怎么测出区别)。早期的Benchmark可能更加侧重贴图和像素部分。新一代的Benchmark则提升了场景复杂度,对多边形和Shader计算的压力进一步增大,例如GLBenchmark 从2.1到2.5的提升。因此,一些三角形生成能力和原生Shader计算能力高的GPU,比如Adreno 220/225,得分提升就会比较明显。
2013年02月03日 03点02分 15
level 12
845647723 楼主
而Mali-400则在2.5中遇到三角形生成的瓶颈,得分表现不如之前。
而游戏是给人玩的,终端厂商或是SOC厂商可以跟游戏厂商合作,针对GPU的特点进行相应的优化。不同GPU侧重很不一样,比如Mali-400,三角形很弱,像素部分,填充率强。高通Adreno 2xx,Vivante的GPU,多边形很强,Shader计算强,但填充率较弱。如果场景对Mali优化,游戏商可以减少画面中多边形的量,用贴图和像素部分实现更多的特效。这样对Adreno 2xx系列不利。如果对Adreno优化,则可以增加场景复杂度,用更多的三角形进行更精细的建模,但这样对Mali则不利。这只是一方面,在一些细节上,还可以进行更深层次的优化,各家的GPU也都会提供相应的工具。
最后,GPU的跑分在一定程度上能反映GPU的实际性能,但最终在游戏中的表现还是很看厂商优化的。所以也不要一味的盯着跑分,多问问玩过的朋友,多看看实测,会更有帮助。
2013年02月03日 03点02分 16
level 12
太长不看
2013年02月03日 04点02分 18
。。
2013年02月03日 04点02分
level 10
好在找个屏幕和拍照以及cpu的详解
2013年02月03日 04点02分 19
等会明天或者后天。。不急。。
2013年02月03日 04点02分
level 11
感谢
2013年02月03日 06点02分 20
level 12
845647723 楼主
GPU肤浅介绍)(高通吧,炮神)

先做几个基础铺垫:
1. GPU处理的东西 主要是顶点(vertex)和像素(pixel)
这两东西一般有四个属性:
vertex: xyzw,就是坐标了~
pixel:rgba,就是颜色rgb加上透明度alpha通道
2. SIMD,Single Instruction Multiple Data,单指令多数据流
一条指令对多个数据进行同样的操作,结合1来看,比如我要把
a的xyzw 分别和 b的xyzw相加,分别赋值给c的xyzw,如果傻做,就是:
c.x = a.x + b.x
c.y = a.y + b.y
c.z = a.z + b.z
c.w = a.w + b.w
要四个周期
如果用SIMD,一个周期就搞定:
c.xyzw = a.xyzw + b.xyzw
3. ADD,就是加法,a+b,算一个浮点操作(FLOPS)
MUL,就是乘法,a*b,算一个FLOPS
MADD,乘加,a*b+c,算2个FLOPS
4. GPU干些啥活?我用很粗俗,不准确的话说吧:
从CPU拿到一堆顶点数据,在空间里画一堆三角形建模,这时候要做一些顶点计算,vertex shader就派上用场了(当然有各种各样的计算,最简单的比如,人物的手绕着关节动,为了省事,程序员用的手的坐标是相对关节的,所以要换算成绝对坐标,这个得计算吧)
然后呢,从摄像机的视野,得到2D画面,对它进行光栅化(变成像素图了)
这个像素图呢,喂给pixel shader进行各种处理,上色,做各种特效啦啥的
最后一些后期加工,OK
2013年02月04日 05点02分 21
level 12
845647723 楼主
3.3.2 喜闻乐见的Adreno系列
类似于PowerVR SGX,其单个计算单元,同样采用vec4+1的架构,当然那1个也是拿来做specialfunction的貌似,所以算前面的vec4,能力是一样的。
但不同的是,Adreno系列只支持FP32计算,即高/中/低精度,全部用FP32精度进行计算,所以可以说,计算能力是实打实的GFLOPS吧。
Adreno 200, 2Vec4 + 1TMU, 133MHz,2.1GFLOPS
Adreno 205, 4Vec4 + 1TMU, 266MHz,8.5GFLOPS
Adreno 220, 8Vec4 + 2TMU, 266MHz,17GFLOPS
Adreno 225, 8Vec4 + 2TMU, 400MHz,25.6GFLOPS
Adreno 320, 目测16vec4 + 4TMU, 如果500MHz的话,就是51GFLOPS
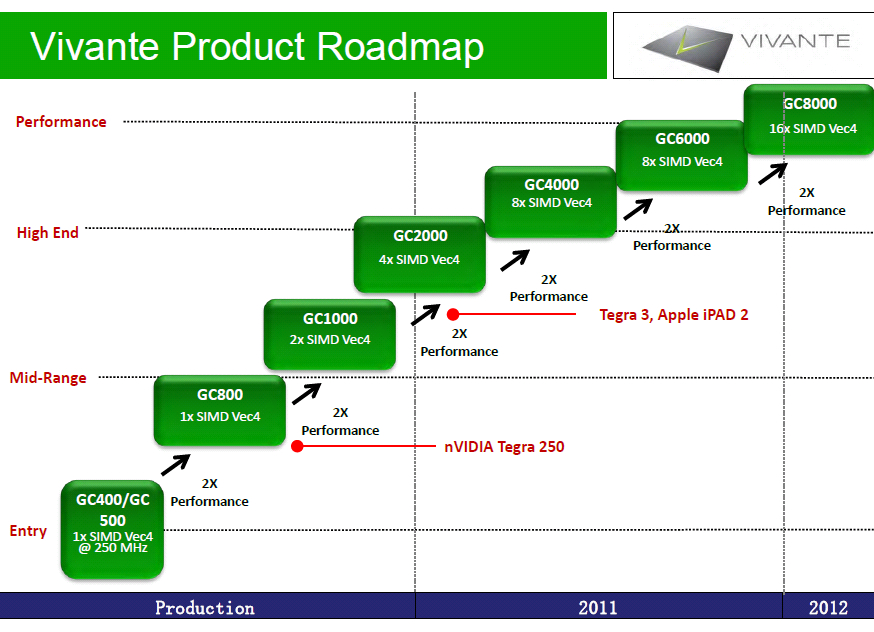
3.3.3 Vivante的GC系列
跟Adreno差不多,也是vec4 SIMD,同样只支持FP32精度
不过Vivante这货的特点是跑高频。。。所以他们一直鼓吹同样的性能,面积最小
所以
RK29的GC800, 1Vec4, 450MHz,3.6GFLOPS
飞思卡尔i.MX6的GC2000, 4Vec4,~600MHz,19.2GFLOPS
华为海思K3V2,GC4000+(或者叫GC6000?),8Vec4,680MHz, 43.5GFLOPS
3.3.4 Mali系列
因为T系列还没产品上市。。。所以说说Mali-400吧
Mali-400并非Unified Shader,是顶点和像素处理分开的
一个顶点处理器包含一个Vertex shader ,vec4,支持FP32精度
一个像素处理器包含一个vec4的pixel shader,以及一个TMU, shader支持FP16精度
所以,一个Mali-400“单核”,400MHz下,计算能力为6.4GFLOPS
如果是MP4,266MHz,则为10.6GFLOPS
MP4, 400MHz,则为16GFLOPS
3.3.5 GeForce ULP
GeForce ULP的vertex shader和pixel shader都是scalar的,并非vec4
顶点支持FP32精度,像素部分支持FP20和FX10精度
所以,“8核”tegra 2, 300MHz,计算能力为4.8GFLOPS
“12核”Terga3, 600MHz,计算能力为14.4GFLOPS
2013年02月04日 05点02分 24
level 12
845647723 楼主
2个Vivante的图
2013年02月04日 05点02分 25
level 12
845647723 楼主
之后说一下,GPU架构 和 纹理格式
4.1 架构,或者说是渲染模式
4.1.1 Imgtec,PowerVR系列,TBDR(TileBasedDeferred Rendering)
特点: 分块,把画面分成小块,这样可以在片上的高速缓存里处理
HSR(Hidden Surface Removal),有专有的硬件单元,在筛掉图像中被遮挡的部分后,才进行光栅化,这样被遮挡的部分就不用被渲染了。节省了计算资源(shader)和带宽(纹理拾取)。
看着非常雕的样子,确实很牛x,imgtec认为能提供等效2.5X的能力(一般按照3的overdraw算到话。。。其实想想也是,场景中被遮挡的看不到的部分太多了。。)不过场景非常复杂时,就容易撑爆管线或者cache,就sb掉了,另外做alphatest的代价也很大(碰到一堆半透明的玩意就哭了,测试代价很大)
不过现在的PowerVR都太牛x了,貌似还没被撑爆过。。。(或者说高压力下会悲剧?谁拿个SGX530跑1080p Glbenchmark 2.5试试?)
4.1.2 Mali/ Adreno, Tiled Based Rendering
这俩也是分块渲染的,同样把画面切成小块,丢到片上高速存储里渲染,不同的是没有HSR功能
不过,还是支持些early-z的测试,减少overdraw(具体我就说不清了,自己还没吃透)
但区别是,Mali和SGX的“块”比较小,一般是16×16这样的
而Adreno的“块”很大。。。以256K为单位,确切的说,大部分的Adreno都带有256K的缓存,画面以这个大小为单位进行渲染
就像上下这两种区别:
不过,新一代的Adreno 3xx,除去tiled渲染,也开始支持传统的渲染方式(IMR,见下)
2013年02月04日 05点02分 26
1 2 3 4 尾页